
Cos’è l’Inferenza nell’AI e perché bisogna conoscerla
Quando utilizziamo un sistema di Intelligenza Artificiale generativa, siamo abituati a concentrarci su due elementi: ciò che inseriamo e ciò che riceviamo. Scriviamo un prompt, alleghiamo eventualmente un documento e attendiamo una risposta.
Tra questi due momenti, però, avviene qualcosa di fondamentale: l’inferenza.
Cos’è l’inferenza nell’AI e perché bisogna conoscerla
L’inferenza è il processo che avviene tra i due.
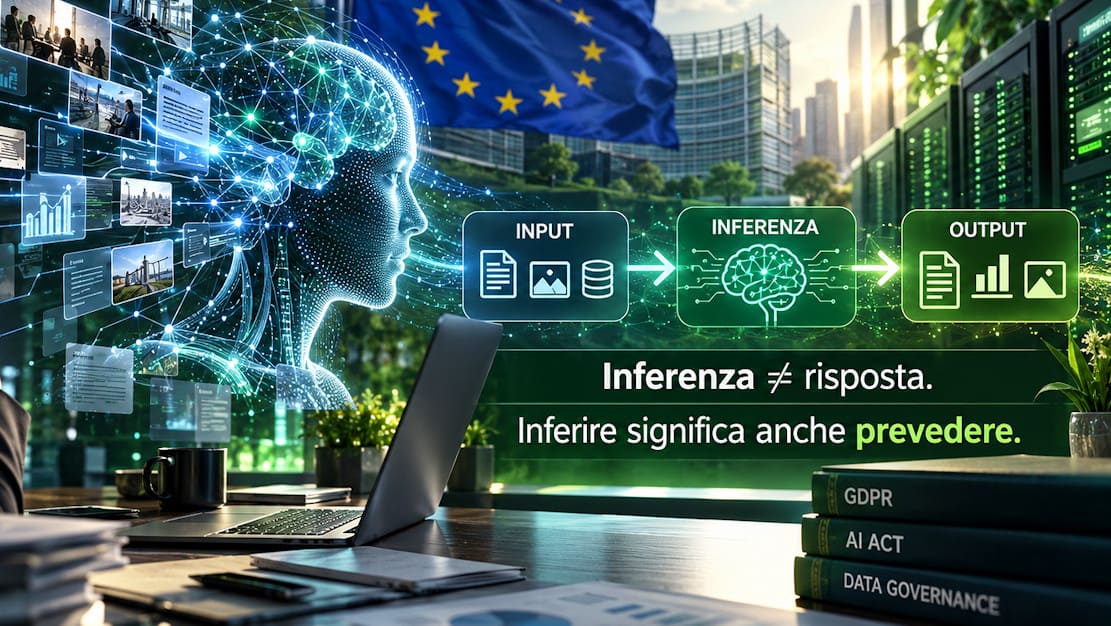
Inferire significa anche prevedere
Un risultato plausibile non è necessariamente un risultato vero
Il problema privacy: l’AI può ricavare informazioni che non abbiamo scritto?
Anonimizzazione e pseudonimizzazione non sono la stessa cosa
Un esempio molto concreto con l’AI generativa
Capire l’inferenza è anche AI Literacy
L’inferenza è un termine apparentemente tecnico, ma comprenderlo è importante soprattutto per chi utilizza l’AI in azienda e ancora di più per Data Controller e Data Processor, perché aiuta a capire cosa accade alle informazioni che affidiamo a un sistema di Intelligenza Artificiale e perché il risultato ottenuto non deve essere automaticamente considerato un fatto.
Possiamo partire da una rappresentazione molto semplice:
INPUT → INFERENZA → OUTPUT
L’input è ciò che forniamo al sistema: un prompt, un testo, un’immagine, un documento o un insieme di dati.
L’output è il risultato: una risposta, una classificazione, una previsione, un’immagine, un suggerimento o perfino un’azione.
L’inferenza è il processo che avviene tra i due.
Un modello già addestrato utilizza quanto ha appreso durante il training per elaborare nuovi dati e produrre un risultato. È quindi la fase operativa dell’Intelligenza Artificiale: quella nella quale il modello viene effettivamente utilizzato. Questa distinzione tra training e inferenza costituisce anche il punto di partenza del materiale preparatorio dell’articolo. INFERENZA – COS’é
È importante, quindi, non confondere inferenza e risultato.
Inferenza ≠ risposta.
La risposta è ciò che vediamo alla fine. L’inferenza è il processo attraverso il quale il sistema arriva a produrla. INFERENZA – COS’é
Inferire significa anche prevedere
Il termine diventa ancora più comprensibile se torniamo al significato comune di “inferire”: partire da alcune informazioni per ricavarne qualcos’altro.
È esattamente ciò che fanno molti sistemi di AI.
Un algoritmo può analizzare dati storici e stimare la probabilità che un cliente interrompa un servizio, che una macchina presenti un’anomalia o che una determinata transazione sia fraudolenta. In altri casi può classificare un’immagine oppure stimare un rischio.
L’inferenza può quindi assumere anche la forma di una previsione.
Occorre però fare attenzione al significato della parola. L’AI non “vede il futuro”. Calcola, sulla base dei dati disponibili e dei modelli appresi, quale risultato risulta statisticamente plausibile.
Inoltre, in molti sistemi predittivi caratterizzati da fenomeni molto variabili, le previsioni possono risultare più affidabili su un orizzonte temporale breve rispetto a uno molto lontano: aumentando l’orizzonte della previsione aumentano anche le variabili e l’incertezza. Non è però una regola universale dell’AI: dipende dal modello, dai dati e dal fenomeno che si sta cercando di prevedere.
Con l’AI generativa il concetto di “brevissimo termine” diventa ancora più interessante.
Un Large Language Model genera normalmente il testo in maniera autoregressiva: sulla base del prompt e dei token precedenti calcola una distribuzione di probabilità per il token successivo, ne seleziona uno e ripete il processo. In altre parole, la generazione di una risposta lunga nasce da una successione di previsioni a cortissimo raggio. Microsoft Learn
È una buona ragione per non immaginare un chatbot come un archivio che contiene già la risposta completa e la recupera quando poniamo una domanda.
La risposta viene generata durante l’inferenza.
Un risultato plausibile non è necessariamente un risultato vero
Questa caratteristica ci porta direttamente a una conseguenza operativa.
Un sistema può produrre un risultato estremamente convincente e, nello stesso tempo, sbagliato.
Se chiediamo a un sistema AI di analizzare un documento relativo a un cliente, a un lavoratore o a un candidato e di formulare una valutazione, ciò che riceviamo potrebbe essere una inferenza statistica, non l’accertamento di un fatto.
La distinzione è particolarmente importante quando entrano in gioco dati personali.
Anche le indicazioni dell’ICO sull’AI e sulla protezione dei dati distinguono l’accuratezza dei dati dall’accuratezza statistica di un sistema. Un output può rappresentare una stima statisticamente informata di qualcosa che potrebbe essere vero riguardo a una persona, oggi o in futuro. Proprio per questo viene raccomandato di non presentare automaticamente inferenze e previsioni come fatti accertati. ICO
Pensiamo alla differenza tra:
“Il cliente non è solvibile”
e
“Il sistema attribuisce al cliente un’elevata probabilità di insolvenza sulla base dei dati analizzati.”
Sembrano affermazioni simili. Dal punto di vista della qualità dell’informazione e delle conseguenze che possono derivarne, non lo sono affatto.
Il problema privacy: l’AI può ricavare informazioni che non abbiamo scritto?
Qui l’inferenza diventa particolarmente interessante per Data Controller e Data Processor.
Un sistema non si limita necessariamente a utilizzare separatamente le informazioni ricevute. Può individuare correlazioni, classificare, confrontare elementi e ricavarne ulteriori informazioni.
Da dati apparentemente innocui potrebbero, ad esempio, essere inferiti interessi, abitudini, condizioni economiche, comportamenti, preferenze o altri elementi riferibili a una persona.
Il GDPR conosce bene questa logica. La definizione di profilazione comprende infatti il trattamento automatizzato di dati personali utilizzato per valutare aspetti personali e, in particolare, per analizzare o prevedere elementi riguardanti rendimento professionale, situazione economica, salute, preferenze, interessi, affidabilità, comportamento, ubicazione o spostamenti.
Con l’AI questa capacità assume una dimensione particolarmente rilevante.
Il NIST, occupandosi dei rischi della GenAI, richiama espressamente la possibilità che i modelli producano informazioni attraverso inferenze predittive che vanno oltre quanto l’utente ha esplicitamente dichiarato. E segnala un punto ancora più delicato: un’inferenza relativa a una persona può creare problemi anche quando è sbagliata, soprattutto se viene utilizzata per prendere decisioni che la riguardano. NIST SI Resource Center
Togliere nome e cognome può non bastare
Da qui nasce un’altra questione molto pratica.
Supponiamo di voler utilizzare un servizio gratuito di AI generativa per analizzare una situazione relativa a un dipendente.
Prima di inserire il testo eliminiamo:
Mario Rossi
e scriviamo:
Dipendente X.
Abbiamo anonimizzato il documento?
Non necessariamente.
Se nello stesso prompt scriviamo che Dipendente X è il responsabile commerciale della filiale di Vicenza, ha 58 anni, è l’unico lavoratore con quella funzione e ha avuto uno specifico episodio disciplinare la settimana precedente, potremmo aver eliminato il nome ma conservato informazioni sufficienti a renderlo identificabile.
Il problema, quindi, non è soltanto eliminare gli identificatori diretti. Bisogna valutare anche la combinazione degli identificatori indiretti.
Il NIST utilizza significativamente il termine inference anche per descrivere la possibilità di dedurre l’identità di una persona attraverso gli “indizi” presenti nei dati, nonostante siano stati rimossi identificatori espliciti come nome o altri codici identificativi. NIST CSRC
Anonimizzazione e pseudonimizzazione non sono la stessa cosa
Questa distinzione diventa essenziale quando utilizziamo strumenti AI.
La pseudonimizzazione consiste nel trattare i dati in modo che non possano più essere attribuiti a una specifica persona senza utilizzare informazioni aggiuntive, purché queste siano conservate separatamente e adeguatamente protette.
Il dato pseudonimizzato, però, rimane dato personale.
L’EDPB ha dedicato specifiche Guidelines 01/2025 proprio alla pseudonimizzazione, confermandone l’importanza come misura per ridurre i rischi nel trattamento dei dati personali. European Data Protection Board
L’anonimizzazione punta invece a una situazione differente: rendere l’interessato non identificabile in modo effettivo. Non basta quindi sostituire automaticamente nome e cognome con “Cliente A” o “Dipendente B”.
Ed è proprio l’inferenza a ricordarci perché.
Un’identità può emergere anche dalla combinazione delle informazioni rimaste.
Un esempio molto concreto con l’AI generativa
Immaginiamo un responsabile HR che debba predisporre una comunicazione e decida di utilizzare un chatbot gratuito.
Prima di inserire il caso elimina il nome del lavoratore, ma lascia:
- mansione;
- sede di lavoro;
- anzianità;
- età;
- dettagli dell’episodio;
- informazioni sulla salute;
- riferimenti ai colleghi coinvolti.
Dal punto di vista organizzativo non possiamo fermarci alla domanda:
“Ho cancellato il nome?”
La domanda corretta diventa:
“Le informazioni che sto fornendo, considerate insieme, consentono ancora di identificare direttamente o indirettamente una persona?”
E subito dopo ne arriva un’altra:
“Era davvero necessario fornire tutte queste informazioni all’AI per ottenere il risultato che cercavo?”
Qui il tema dell’inferenza incontra direttamente i principi di minimizzazione, necessità e gestione del rischio.
Cinque accorgimenti prima di utilizzare un’AI generativa
Per Data Controller e Data Processor la prima misura non deve essere necessariamente tecnica. Molto spesso è organizzativa.
Prima di utilizzare informazioni aziendali con un sistema di AI generativa è opportuno chiedersi quali dati siano realmente necessari. Se per correggere grammaticalmente una comunicazione non serve conoscere il nome del destinatario, quel nome non dovrebbe essere inserito.
Quando possibile, occorre poi eliminare o generalizzare gli elementi identificativi non necessari: non soltanto nome, cognome, email e telefono, ma anche riferimenti indiretti che, combinati, potrebbero consentire l’identificazione.
Se si ricorre alla pseudonimizzazione, bisogna ricordare che non equivale ad anonimizzazione e non fa uscire automaticamente il trattamento dal perimetro GDPR.
Occorre inoltre conoscere le condizioni del servizio utilizzato: conservazione degli input, eventuale utilizzo dei contenuti per migliorare i sistemi, localizzazione dei trattamenti, configurazioni disponibili e garanzie contrattuali. Il fatto che un servizio sia gratuito o facilmente accessibile non elimina le responsabilità dell’organizzazione.
Infine, un’inferenza prodotta dall’AI dovrebbe essere trattata per quello che è: un risultato da valutare, non una verità da accettare automaticamente.
Capire l’inferenza è anche AI Literacy
Conoscere questi meccanismi non significa trasformare ogni lavoratore in un informatico o in un Data Scientist.
Significa sviluppare la consapevolezza necessaria per utilizzare l’AI correttamente.
Ed è esattamente uno degli obiettivi dell’AI Literacy: comprendere capacità, limiti e rischi dei sistemi che utilizziamo. Nella formulazione attualmente vigente dell’articolo 4 dell’AI Act, provider e deployer devono adottare misure volte a sostenere lo sviluppo dell’alfabetizzazione in materia di AI del personale e delle altre persone che utilizzano sistemi AI per loro conto, considerando conoscenze, esperienza, formazione e contesto d’uso. EUR-Lex
Sapere cos’è l’inferenza rientra perfettamente in questa consapevolezza.
Perché aiuta a comprendere che l’AI non si limita a conservare o restituire ciò che le abbiamo fornito. Elabora gli input, individua relazioni, produce probabilità e può generare nuove informazioni.
E soprattutto aiuta a ricordare una regola fondamentale:
l’output dell’AI è il risultato di un processo di inferenza. Può essere straordinariamente utile, ma deve rimanere sottoposto al giudizio umano.
– Trasparenza AI – Questo contenuto è stato realizzato con il supporto di sistemi di Intelligenza Artificiale generativa. Il contenuto finale è sottoposto a revisione umana e controllo editoriale ed è validato da Kairos s.r.l., che ne assume la responsabilità editoriale.
Scopri come utilizziamo l’Intelligenza Artificiale →